TL;DR
📌 Ce qu’il faut savoir :
- Jev ne génère pas de texte. On lui donne un contenu et des questions typées, il répond par des valeurs typées et des probabilités
- Trois types de questions : Noul (oui/non), Choice (une option parmi une liste fermée), Score (une position sur des niveaux ordonnés)
- 0,042 $ par million de tokens en entrée, tokens de sortie gratuits, et quelques centaines de millisecondes par appel
- Mesuré sur ma démo : 1 000 demandes de support qualifiées en 25 secondes, 3 questions chacune, soit 3 000 décisions, 0 échec, environ 0,03 $
- « Ne peut pas halluciner » porte sur la forme de la réponse, pas sur sa justesse : il peut se tromper, et avec une confiance de 1,00
- Ce n’est pas un remplaçant des LLM, c’est un complément : lui prend les réflexes, le LLM rédige et raisonne
Dépôt de démonstration : yoanbernabeu/demo-symfony-typesafe
1. Un modèle d’IA qui ne sait pas écrire
Votre code a besoin d’une décision, pas d’un texte
Regardez honnêtement ce que vous demandez à un LLM dans une application : bien souvent, ce n’est pas un texte. C’est une décision. Ce message est-il urgent ? Dans quelle file ce ticket doit-il partir ? Ce commentaire est-il du spam ? Cette ligne correspond-elle à ce produit ?
Avant les LLM, on bricolait :
if (str_contains(strtolower($message), 'urgent')) {
    $this->escalate($ticket);
}
Ce if rate « je n’ai plus de quoi payer mon loyer », et se déclenche sur « rien d’urgent, merci ».
Avec un LLM, on s’en sort par un détour : on lui fait générer du texte. Longtemps, il a fallu lui demander poliment du JSON, puis parser le résultat en croisant les doigts. Aujourd’hui, certains modèles proposent des sorties structurées, qui garantissent le respect d’un schéma JSON : le problème du format est réglé. Mais le détour, lui, reste entier : on paie des tokens de sortie, on attend qu’ils s’écrivent un par un, et on obtient « oui » ou « non », sans probabilité sur laquelle poser un seuil.
Jev prend le problème à l’envers. C’est le premier modèle d’une nouvelle famille que TypeSafe AI appelle « System One », présenté mi-septembre 2026 dans un billet signé de son fondateur, Diogo Almeida. La promesse tient en une phrase de la documentation :
« System One models make fast, structured decisions for software. »
Concrètement, le if de tout à l’heure devient une question oui/non posée en langage naturel, à laquelle Jev répond par une probabilité (exemple illustratif, écrit avec le bridge Symfony AI présenté en partie 4) :
$answers = $platform->invoke('jev-latest', new Evaluation($message, [
    'urgent' => new NoulQuestion('La personne qui écrit ce message a besoin d’une réponse dans la journée'),
]))->asObject();

if ($answers->getNoul('urgent')->isTrue(0.8)) {
    $this->escalate($ticket);
}
Ce if-là lit le message. Et il ne s’exécute que si Jev est sûr à 80 % : le seuil, c’est vous qui le posez.
Système 1, système 2
Le nom vient de Thinking, Fast and Slow (Système 1 / Système 2) de Daniel Kahneman. Le système 1, c’est la pensée rapide et intuitive : reconnaître un visage, freiner devant un obstacle. Le système 2, c’est le raisonnement lent et délibéré : remplir sa déclaration d’impôts, poser une division.
Les LLM qui « réfléchissent » avant de répondre sont du système 2. Jev est du système 1 : le gardien de but qui plonge, pas l’entraîneur qui analyse le match le lendemain.
Ce qu’il fait : trois primitives
On donne à Jev un state (un contenu : du texte, du JSON, un tableau de textes) et des questions typées. Il répond par des valeurs typées et des probabilités. TypeSafe appelle ces types de questions des primitives, et il y en a trois :
| Primitive | La question | La réponse |
|---|---|---|
| Noul | Une question oui/non | Une probabilité entre 0 et 1 : près de 1 c’est oui, près de 0 c’est non, vers 0,5 c’est « je ne sais pas » |
| Choice | Une option parmi une liste fermée | L’option retenue, la probabilité de chaque option, et une confiance |
| Score | Une position sur des niveaux ordonnés, décrits en clair | Un score qui peut tomber entre deux niveaux, les probabilités, et une confiance |
Détail qui compte : plusieurs questions peuvent partir dans le même appel. Elles sont évaluées en parallèle sur le même contenu. On y revient, c’est une des clés du modèle économique.
À quoi ressemble une réponse
Rien ne vaut le JSON brut. Voici la réponse de l’API pour une vraie demande de la démo de la partie 4 (« Impossible de récupérer nos documents de montant net social sur site caf… »), à laquelle on pose trois questions en un seul appel : intention (un Choice à six options), priority (un Score à quatre niveaux) et bug (un Noul).
{
    "model": "jev-1.13.0",
    "answers": {
        "intention": {
            "type": "choice",
            "choice": "debloquer",
            "confidence": 0.93,
            "probabilities": {
                "contester": 0,
                "debloquer": 0.94,
                "information": 0.05,
                "accueil": 0.01,
                "remercier": 0,
                "amelioration": 0
            }
        },
        "priority": {
            "type": "score",
            "score": 2.88,
            "confidence": 0.88,
            "legend": [
                "Aucune urgence : un remerciement ou une simple remarque",
                "Peut attendre : une gêne sans conséquence concrète",
                "À traiter vite : une démarche est bloquée depuis des semaines",
                "Urgence : la personne est privée de revenus, de papiers ou de soins"
            ],
            "probabilities": [0, 0, 0.12, 0.88]
        },
        "bug": {
            "type": "noul",
            "noul": 0.87
        }
    },
    "usage": {
        "input_tokens": 628,
        "output_tokens": 101
    }
}
Trois choses à lire dans cette réponse :
- le Choice donne l’option retenue, mais aussi la probabilité de chaque option. La
confidenceest un chiffre distinct de la probabilité de l’option gagnante (ici 0,93 et 0,94, mais l’écart peut être bien plus net) : elle résume toute la distribution en un seul nombre, et des options au coude-à-coude donnent une confiance basse même si l’une d’elles l’emporte. La documentation lui consacre une page ; - le Score vaut 2,88 parce que Jev place 12 % de probabilité sur le niveau 2 et 88 % sur le niveau 3 : 2 × 0,12 + 3 × 0,88. C’est ce qui lui permet de tomber entre deux niveaux ;
- l’usage : 628 tokens en entrée, 101 en sortie. Seuls les premiers sont facturés.
Ce qu’il ne fait pas
TypeSafe publie une page entière sur les limites connues de Jev 1.13, et c’est assez rare pour être salué. En résumé :
- Il ne génère pas de texte. Pas de résumé, pas de réponse rédigée, pas de code : « Jev is not trained to generate text ».
- Texte seulement : ni image, ni audio, ni vidéo.
- Ce n’est pas une calculatrice : il compte mal, et compare mal des dates (il les lit « comme du texte, pas comme des quantités ordonnées »).
- Il lit littéralement : il répond à la question que vous avez écrite, pas à celle que vous aviez en tête. Les doubles négations et les raisonnements en plusieurs étapes dégradent la fiabilité.
- La précision baisse quand le state est gros et rempli de détails hors sujet.
- Il ne traite pas les données comme hostiles : une instruction injectée dans le contenu peut déplacer la réponse. À garder en tête dès que la décision a des conséquences.
- Pas de fine-tuning sur vos données. TypeSafe indique par ailleurs ne pas entraîner Jev sur les requêtes de ses clients.
- L’anglais d’abord : c’est la langue principale d’entraînement, celle où la précision est la meilleure. Les autres langues sont « gérées, mais pas aussi bien ». Mes essais en français sont pourtant bons, on les verra plus bas.
Le prix
C’est le chiffre qui fait lever un sourcil (page Models, recoupée avec le tableau de bord de mon compte) :
- 0,042 $ par million de tokens en entrée. TypeSafe l’écrit aussi « 42 $ par milliard », ce qui donne une idée de l’échelle visée.
- Les tokens de sortie sont gratuits.
À titre de comparaison, le billet de lancement cite pour les LLM une fourchette de 0,20 $ à 10 $ par million de tokens en entrée, avec une sortie environ cinq fois plus chère.
Pour donner un ordre de grandeur concret : toute ma matinée d’essais, soit 3 729 requêtes et 3,3 millions de tokens en entrée, a coûté environ 0,14 $ d’après l’export de mon compte. Plus tard dans la journée, le tableau de bord affichait 0,1656 $ pour 5,7 millions de tokens, entrée et sortie confondues (ses statistiques peuvent avoir un peu de retard).
Détail pratique : mon compte affichait un « Monthly credit » de 5,00 $, valable un mois. Je ne sais pas s’il s’agit d’une offre générale ou d’une particularité de mon compte, je vous le signale donc avec réserve. À ce tarif, 5 $ représentent de toute façon beaucoup d’essais.
La rapidité
Ici, il faut distinguer ce qu’annonce TypeSafe et ce que j’ai mesuré.
Ce qu’annonce TypeSafe : de 70 à 500 ms de bout en bout, contre 3 à 329 secondes pour les LLM de sa comparaison. La documentation précise que la plupart des requêtes se terminent en 100 ms environ.
Ce que j’ai mesuré, depuis la France, réseau compris, sur 1 000 appels :
| Mesure | Latence |
|---|---|
| Moyenne | 428 ms |
| Médiane | 441 ms |
| 95ᵉ centile | 688 ms |
| Maximum | 1 114 ms |
Je n’ai jamais observé les 100 ms : sur ces 1 000 appels, le plus rapide a pris 228 ms, et 275 sont passés sous les 300 ms. Mon expérience, c’est quelques centaines de millisecondes par appel, ce qui reste sans commune mesure avec les secondes d’un LLM, surtout quand chaque appel répond à trois questions à la fois.
Pourquoi c’est intéressant
La forme de la réponse est garantie par construction. Plus de JSON mal fermé, plus de « Bien sûr ! Voici la classification demandée : ». Un Choice renvoie une des options que vous avez listées, point. Les sorties structurées de certains LLM offrent la même garantie ; la différence, c’est qu’ici elle ne passe pas par une génération token par token, et qu’elle s’accompagne d’une probabilité.
Une probabilité, ça se pilote. Là où un LLM vous dit « oui », Jev vous dit « 0,86 ». Vous posez un seuil, vous automatisez ce qui est net, et vous envoyez les cas incertains à un humain ou à un modèle plus gros. La documentation appelle ça le confidence-gated routing :
Le prix et la latence changent ce qu’on ose faire. À ce tarif, on peut appeler le modèle sur chaque message, chaque ligne, chaque événement. TypeSafe parle de smart if-statements : c’est exactement le if du début de cet article.
Le principe de conception recommandé est d’ailleurs d’une sobriété réjouissante : « code owns the workflow and AI handles narrow, structured decisions ». Autrement dit : construisez un workflow logiciel normal, et n’insérez le System One que là où il faut de l’IA. Pas d’agent autonome, pas de boucle magique : votre code décide du déroulé, le modèle tranche des questions étroites.
Ce n’est pas un remplaçant des LLM. C’est un complément. Le System One prend les réflexes (garde-fous, routage, tri), le System Two rédige et raisonne. On trouve d’ailleurs dans la galerie communautaire des agents navigateur accélérés par Jev.
La nuance honnête
Deux réserves, à garder en tête pour toute la suite.
« Ne peut pas halluciner » porte sur la forme, pas sur la justesse. L’analyse de TrueFoundry, la plus critique et la plus utile que j’aie lue, le dit très bien : un modèle contraint à trois catégories autorisées peut toujours choisir la mauvaise avec aplomb. J’ai constaté exactement cela, exemples à l’appui en partie 3.
Les chiffres spectaculaires viennent du vendeur. « 193,6 fois plus rapide », « 444,6 fois moins cher », parité d’intelligence avec les LLM de pointe (les modèles cités sont GPT-5.6 Terra, GPT-6 Astra et Claude Fable 5.1) : ce sont des évaluations internes de TypeSafe, non reproduites de façon indépendante à ce jour.
Ce qui est vérifiable par n’importe qui, en revanche : le prix public, le respect du schéma, la latence par appel. C’est ce que j’ai vérifié, et c’est ce que vous pourrez vérifier avec la démo.
La fiche technique, pour référence
| Caractéristique | Valeur |
|---|---|
| Modèle | jev-1.13.0, avec deux alias, jev-latest et jev-preview, qui pointent aujourd’hui tous deux dessus |
| Entrées | Texte seulement |
| Prix | 0,042 $ par million de tokens en entrée, sortie gratuite |
| Latence annoncée | 70 à 500 ms, environ 100 ms pour la plupart des requêtes |
| Latence mesurée | 441 ms de médiane, depuis la France, réseau compris |
| Taille d’une requête | 64 000 tokens, dont 32 000 pour le state et la plus longue question |
| Débit | 250 000 tokens par seconde et 1 200 requêtes par minute, erreur 429 au-delà |
| Accès | Accès anticipé, via une API hébergée |
| Outillage | SDK officiels Python et JavaScript/TypeScript, « agent skill » pour Claude Code et Codex. Pas de SDK PHP : c’est ce qui nous amènera au bridge Symfony AI |
2. Comment fonctionne Jev, sans les maths
TypeSafe ne publie ni l’architecture détaillée, ni le nombre de paramètres. Ce qui suit vulgarise ce que disent le billet de lancement et l’« AI primer » de la documentation.
Le rédacteur et le formulaire
Un LLM est un rédacteur : il écrit sa réponse token par token, et chaque token attend le précédent. C’est ce qu’on appelle un modèle autorégressif. Une réponse de 200 tokens, ce sont 200 étapes à la suite. Même pour répondre « oui ».
Jev est un formulaire à cases : quelqu’un lit le document une fois, puis coche toutes les cases d’un seul regard, en notant à côté de chacune à quel point il est sûr. Il est non autorégressif : il produit toutes ses réponses en une seule passe.
Et comme les cases sont définies à l’avance, il ne peut répondre que dans les cases. C’est pour cela que la forme est garantie : ce n’est pas une consigne qu’il respecte, c’est la seule chose qu’il sait faire.
Trois briques annoncées
TypeSafe met en avant trois ingrédients :
- une nouvelle architecture de modèle (non détaillée) ;
- un « parallel sampler » ;
- une méthode d’entraînement baptisée RLCD, pour Reinforcement Learning for Calibrated Decisions.
Ce dernier point mérite qu’on s’y arrête. Les modèles de chat sont entraînés par RLHF, qui optimise la préférence humaine : une réponse qui plaît. RLCD, d’après TypeSafe, optimise autre chose : l’honnêteté des probabilités.
« Calibré », ça veut dire quoi ?
La définition de TypeSafe : les événements auxquels le modèle attribue une probabilité de 0,2 doivent se produire environ 20 % du temps.
C’est la météo. Un bon prévisionniste n’est pas celui qui ne se trompe jamais, c’est celui chez qui, sur tous les jours annoncés à « 20 % de risque de pluie », il pleut effectivement un jour sur cinq.
Deux conséquences pratiques :
- c’est une propriété statistique, sur des groupes de prédictions. Pas une garantie sur une prédiction isolée ;
- c’est ce qui rend les seuils utilisables : si 0,9 veut vraiment dire 90 %, vous pouvez décider en connaissance de cause du taux d’erreur que vous acceptez d’automatiser.
Le pari de fond de TypeSafe est assumé : l’automatisation sera dominée par des interactions de machine à machine, donc « l’interface machine importe plus que l’interface de chat ».
Pourquoi ajouter des questions ne coûte presque rien
Le contenu n’est lu qu’une fois, et les questions sont évaluées en parallèle dessus. Tant que le contenu pèse plus lourd que les questions, ce qui est le cas le plus courant, chaque question supplémentaire est presque gratuite.
Le cookbook officiel « Parallel questions » donne un exemple chiffré, sur un article Wikipédia de 54 000 caractères et 13 questions :
| Coût | Durée | |
|---|---|---|
| 13 appels séparés | 0,006090 $ | 2,71 s |
| 1 seul appel, 13 questions | 0,000497 $ | 0,27 s |
Soit 12,2 fois moins cher et 10 fois plus rapide. La leçon : regroupez vos questions.
Cinq pièges documentés
La documentation les liste, et ils valent de l’or quand on débute :
- Les identifiants des questions ne sont pas envoyés au modèle. Nommer une question
is_spamne l’aide en rien : toute la question doit tenir dans son énoncé. - 0,5 signifie « je ne sais pas », pas « moyen ». Valable pour un Noul comme pour un Score.
- Prévoyez une option « autre » dans un Choice dès que la liste peut être incomplète. Sinon, il choisira quand même (on verra ce que ça donne avec la Corse).
- Ne transférez pas un seuil d’une primitive à l’autre. Sur un même ticket, un Noul peut donner 0,22 quand un Choice oui/non donne 0,01 / 0,99.
- Décomposez. Plutôt que « est-ce du spam ? », posez des jugements atomiques : « demande-t-il des identifiants ? », « annonce-t-il une récompense inattendue ? ». Puisque les questions supplémentaires ne coûtent presque rien, autant en profiter.
3. À quoi sert Jev : des exemples
La galerie communautaire
jevable.com recense les projets construits avec Jev : 359 au moment où j’écris. Six d’entre eux résument bien les usages, avec les chiffres tels qu’annoncés par leurs auteurs :
| Famille | Projet | Ce qu’il fait |
|---|---|---|
| Des agents plus rapides | A faster browser agent (Browser Use + Jev, Gregor Zunic) | Trouver un vol en 7 secondes pour 0,0039 $ |
| Instant context compaction (tamara) | Noter chaque appel d’outil d’un agent, et jeter ce qui est hors sujet | |
| Des garde-fous pour développeurs | pkg-gate (Hemanth.HM) | Une barrière avant un npm install : un Choice pour l’intention du paquet, un Score pour la gravité, en 100 ms environ |
| jev-codes (Kushal Agarwal) | L’audit d’un git diff contre des règles de code décrites en YAML | |
| Du tri de masse | TC39 Atlas (Hemanth.HM) | 324 propositions JavaScript classées sur 9 dimensions en 12,7 secondes |
| Scoring 3,000 kids’ snacks | 3 000 produits notés en 28 secondes pour 0,11 $ |
On y trouve aussi des jeux (Catan, échecs, Tetris) : un modèle qui choisit vite parmi des options peut jouer. Le billet de TypeSafe cite même Doom, et du « Wikiracing » avec jusqu’à 255 options par décision.
Les recettes officielles
La section Cookbooks de la documentation couvre des cas plus « entreprise ». Quatre à retenir :
- garde-fous pour LLM : filtrer les messages en entrée et en sortie ;
- reranking pour le RAG : la précision top-1 passe de 5 % à 18 % sur des requêtes RGPD ;
- function calling : des requêtes de trading routées vers des fonctions typées ;
- extraction de dates, d’e-mails, de montants.
Le reste (vérification de citations, classification hiérarchique, alignement d’entités, recherche sémantique…) est à parcourir sur place.
Ce que j’ai testé avant de choisir la démo
Avant de construire la démo, j’ai essayé Jev sur quatre jeux de données, pour me faire une intuition. Ce sont des essais uniques sur de petits échantillons, pas des benchmarks.
| Ce que Jev lisait | Ce qu’il devait deviner | Bonnes réponses |
|---|---|---|
Le titre et le texte d’une issue ou d’une PR de symfony/symfony (100 éléments, en anglais) | Bug, feature ou RFC ? | 91 % (sur les 75 qui portaient un label) |
| Le composant concerné, parmi 77 | 70 %, et 85 % dans ses trois premiers choix | |
| La description d’un Pokémon, en français, nom masqué (60 Pokémon) | Son type, parmi 18 | 72 % |
| Le nom d’une commune française, et rien d’autre | Sa région, parmi 14 | 68 % (le hasard ferait 8 %) |
| Plus de 20 000 habitants ? | 97 % |
Ce que j’en retiens :
- C’est rapide : les 100 éléments, avec 4 ou 5 questions chacun, ont été traités en 4,5 secondes.
- La confiance sert à quelque chose : sur le composant, si on ne garde que les réponses dont la confiance atteint 0,8, on passe de 70 % à 83 %. Quand il se dit sûr, il a plus souvent raison.
- Le français passe bien, malgré l’avertissement de la documentation. Réserve : Jev a pu voir le Pokédex pendant son entraînement.
Et comme mille appels coûtent quelques centimes, je me suis aussi amusé avec les communes : un classement des noms les plus gênants (Pisseleu, Condom, Longcochon…) et une carte de l’apéro (cidre en Bretagne, pastis en PACA, champagne dans le Grand Est). Rien de scientifique, mais c’est là que les limites du modèle se voient le mieux, comme on va le voir.
Le quatrième essai, 200 demandes d’usagers des services publics, en français, a donné la démo de la partie 4.
Les limites que j’ai observées
C’est la partie la plus instructive, et elle recoupe la documentation point par point. Chaque limite a sa parade.
Il lit, il n’entend pas. Il repère Pisseleu ou Condom, des mots écrits tels quels. Pas Montcuq ni Trécon, dont le calembour ne fonctionne qu’à l’oral. → Ne lui demandez que ce qui est écrit dans le texte.
Une option dominante écrase un Choice. À « qui habite cette commune ? », il répond « des retraités » pour 385 communes sur 394. À « pain au chocolat ou chocolatine ? », il répond chocolatine pour 98 % de la France. Je laisse le Sud-Ouest savourer, mais c’est bien un biais, pas une enquête. → Piste, que je n’ai pas testée : décrivez chaque option, reformulez la question, ou passez à un Score. Dans ces deux essais, les options étaient de simples libellés. Dans la démo, chaque option est décrite, et la plus choisie plafonne à 43 %.
Une option manquante force une mauvaise réponse. Sans option corse dans la liste, la Corse « boit du génépi et mange du cassoulet ». → C’est le piège n° 3 : prévoyez une option « autre ».
Quand l’information n’est pas dans le texte, il reste près de 0,5. À « cette PR sera-t-elle mergée ? », les probabilités vont de 0,23 à 0,68 et la précision est de 48 % : pile ou face. Et c’est une bonne nouvelle : c’est exactement le comportement attendu d’un modèle calibré. Il ne sait pas, et il le dit. → Traitez la zone autour de 0,5 comme un « je ne sais pas », et routez-la ailleurs.
Il peut se tromper avec une confiance totale. « C’est la pire préfecture de France, ils sont injoignables » a été classé « débloquer un dossier » avec une confiance de 1,00, là où on attendait « se plaindre de l’accueil ». Un seuil élevé réduit les erreurs, il ne les supprime pas. → Relisez régulièrement un échantillon, même au-dessus du seuil.
Plus une question a d’options, plus elle coûte. Un Choice à 77 ou 96 options fonctionne en un seul appel, mais les options font partie de l’entrée : la question aux 96 départements pesait lourd en tokens. Et la précision est plus basse : 46 % pour le département parmi 96, contre 68 % pour la région parmi 14. → Piste suggérée par la documentation, que je n’ai pas testée : hiérarchiser (la région d’abord, le département ensuite), comme dans sa recette de classification hiérarchique.
4. La démo : clonez et jouez
Place à la pratique. Le dépôt : yoanbernabeu/demo-symfony-typesafe, public, sous licence MIT.
Je ne vais pas expliquer l’application ici : ce n’est pas le sujet. Le README est complet, en français, et indique où regarder dans le code. L’objectif de cette partie : que vous ayez Jev sous les doigts en quelques minutes.
Ce que c’est, en une phrase
Une application Symfony qui lit de vraies demandes adressées aux services publics français, et laisse Jev les qualifier avec les trois primitives, en un seul appel par demande :
| Primitive | La question posée | Les réponses possibles |
|---|---|---|
| Choice | Qu’attend la personne ? | Six intentions : débloquer un dossier, obtenir une information, contester une décision, se plaindre de l’accueil, proposer une amélioration, remercier |
| Score | À quel point est-ce urgent ? | De 0 à 3 ; le niveau 3 : « la personne est privée de revenus, de papiers ou de soins » |
| Noul | Est-ce un bug du site à transmettre aux devs ? | Une probabilité |
Les données
Les demandes viennent du jeu « Liste des expériences partagées par les usagers », publié par la DITP (Direction interministérielle de la transformation publique) sur data.gouv.fr sous Licence Ouverte 2.0. Republié chaque jour, il comptait 165 926 témoignages au 19 septembre 2026 ; la démo importe les 71 210 écrits depuis 2025, et n’en garde que l’identifiant, la date et le texte.
Un mot important : ce sont de vrais témoignages, et pour certains de vraies détresses. On peut sourire de la bureaucratie. Pas des usagers.
Mon run de 1 000 demandes
| Mesure | Valeur |
|---|---|
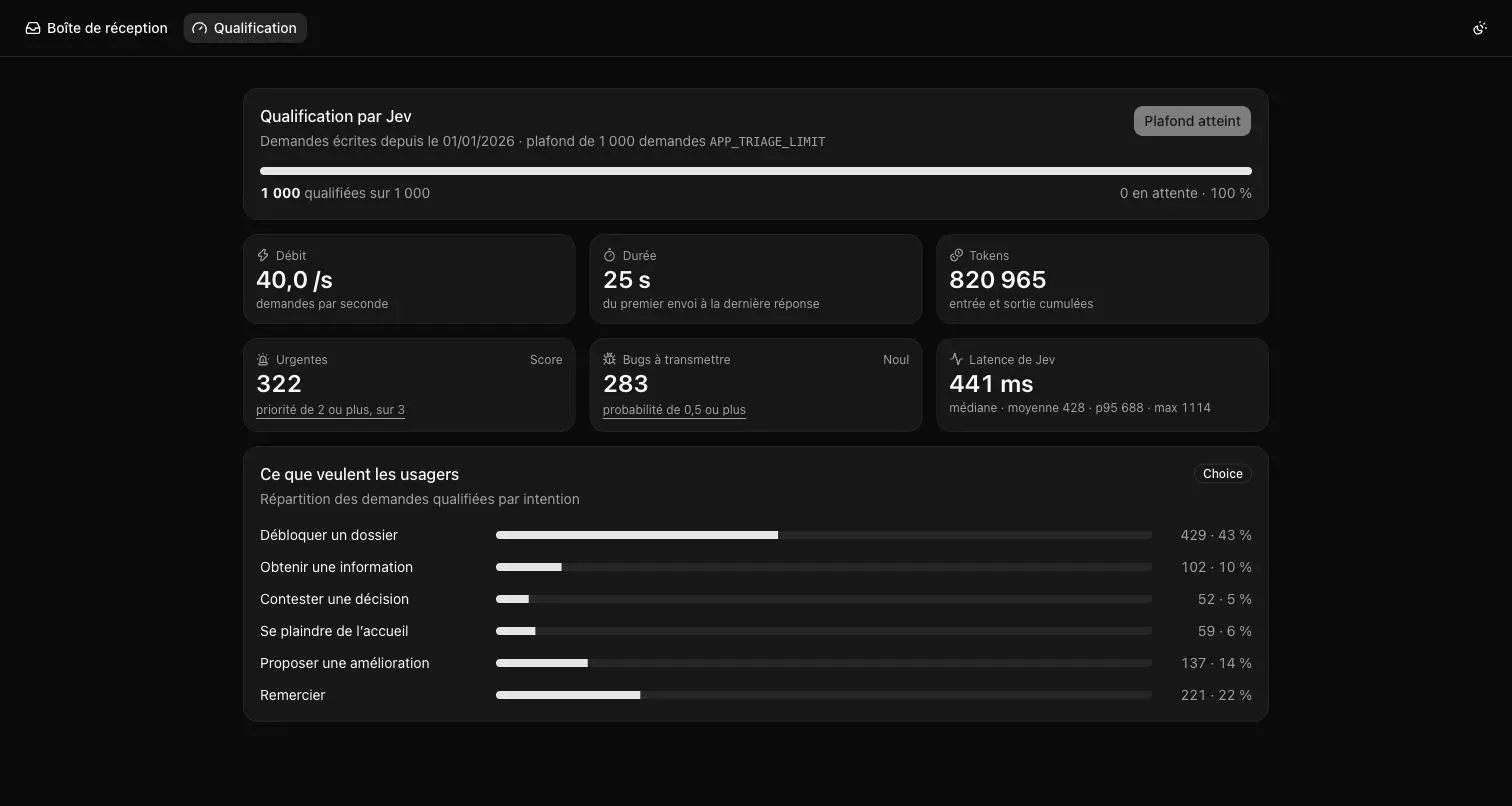
| Demandes qualifiées | 1 000 (les plus récentes de 2026), soit 3 000 réponses |
| Durée | 25 secondes (40 demandes par seconde) |
| Échecs | 0 |
| Tokens | 820 965, soit environ 820 par demande |
| Coût | environ 0,03 $ |
Environ 88 % de ces tokens sont de l’entrée, la seule facturée (proportion mesurée sur un essai préalable de 200 demandes, avec les mêmes questions).
Et ce que Jev en a tiré : 322 demandes urgentes (priorité de 2 ou plus, sur 3), 283 bugs à transmettre (probabilité de 0,5 ou plus), et cette répartition des intentions :
| Intention | Demandes |
|---|---|
| Débloquer un dossier | 429 |
| Remercier | 221 |
| Proposer une amélioration | 137 |
| Obtenir une information | 102 |
| Se plaindre de l’accueil | 59 |
| Contester une décision | 52 |
Par honnêteté : je n’ai pas de vérité terrain sur ces 1 000 demandes. Ces chiffres sont des comptages, pas une mesure de justesse. En revanche, une fois les réponses en base, elles deviennent de simples colonnes : on filtre sur les bugs, on trie par urgence, et la boîte de réception se range toute seule.
Du clone à l’application qui tourne
Prérequis : PHP 8.4, Composer, le Symfony CLI (recommandé) et une clé d’API TypeSafe. Ni Docker, ni Node.js, ni serveur de base de données : tout tient dans SQLite.
La clé se crée dans la console TypeSafe, qui propose aussi un playground pour essayer sans code. Jev étant en accès anticipé, l’ouverture du compte peut passer par une liste d’attente.
git clone https://github.com/yoanbernabeu/demo-symfony-typesafe.git
cd demo-symfony-typesafe
composer install
echo "TYPESAFE_API_KEY=votre-cle" > .env.local
bin/console app:jev:test
bin/console doctrine:migrations:migrate --no-interaction
bin/console app:dataset:download
bin/console app:dataset:import
bin/console tailwind:build
symfony serve
Deux repères dans cette liste :
app:jev:testenvoie un ticket d’exemple à Jev et affiche les réponses typées, les tokens et la réponse brute. Si cette commande répond, votre clé fonctionne. Son ticket d’exemple (un compte Stripe qui ne se connecte pas) est d’ailleurs instructif : Jev hésite entrebilling(autour de 0,65) ettechnical(autour de 0,35), avec une confiance d’environ 0,5 seulement. Exactement le cas qu’on enverrait à un humain ;app:dataset:downloadtélécharge environ 260 Mo depuis data.gouv.fr, ettailwind:buildrécupère son binaire (environ 80 Mo) au premier lancement : ce sont les deux étapes les plus longues. Du clone à l’application qui tourne, comptez moins d’une minute sur ma connexion fibre, et quelques minutes avec une connexion plus modeste ou un cache Composer vide.
Ouvrez ensuite http://127.0.0.1:8000, allez sur la page Qualification, et cliquez sur « Lancer la qualification ».
Par défaut, la démo plafonne à 1 000 demandes (APP_TRIAGE_LIMIT), pour que personne n’ait de surprise sur sa facture. À 0,03 $ le millier, vous avez de la marge, mais c’est vous qui levez le plafond. Pour rejouer : bin/console app:triage:reset.
Si vous levez le plafond : la démo bride aussi son débit à 1 100 requêtes par minute (
APP_TRIAGE_REQUESTS_PER_MINUTE, via le composant RateLimiter de Symfony), pour rester sous la limite officielle de 1 200. Un run de 1 000 demandes tient dans la minute : il n’est pas ralenti. Au-delà, le worker se met en pause jusqu’à la minute suivante, et le tableau de bord l’affiche. Pour les 27 595 demandes de 2026, comptez au moins 25 minutes et autour de 0,85 $ (estimation au même tarif).
Idées pour bidouiller : changez l’énoncé d’une question dans
src/Triage/ExperienceTriage.phpet relancez. Retirez une intention pour voir le Choice forcer une mauvaise réponse. Ajoutez un Noul (« la personne mentionne-t-elle un délai en semaines ? »). Vous sentirez très vite ce que « lecture littérale » veut dire.
Un mot sur le bridge Symfony AI
TypeSafe fournit deux SDK officiels, Python et JavaScript/TypeScript, et pas de SDK PHP. Mais son API HTTP s’appelle depuis n’importe quel langage. J’ai donc écrit un bridge TypeSafe pour Symfony AI, et je l’ai proposé au projet : c’est la PR n° 2549, « [AI Bundle][Platform] Add TypeSafe bridge ».
Soyons clairs sur son statut : à l’heure où j’écris, cette PR est ouverte et en cours de revue. Elle n’est pas mergée. Elle peut évoluer, être profondément remaniée, ou ne pas aboutir : c’est le jeu normal de l’open source, et le dernier mot revient aux mainteneurs de Symfony AI.
En attendant, le bridge est disponible « pour de faux » dans le dépôt de démo :
- il est embarqué dans
packages/ai-type-safe-platform/, et Composer le charge comme un paquet local (dépôt de typepath). Un simplegit clonepuiscomposer installsuffit ; - la plateforme est déclarée à la main dans
config/services.yaml, avec laFactorydu bridge ; symfony/ai-bundleetsymfony/ai-platformsont pris endev-main, et figés par lecomposer.lock.
Si la PR est mergée puis publiée, l’usage deviendrait celui de n’importe quel bridge Symfony AI. Un composer require symfony/ai-type-safe-platform, puis dans config/packages/ai.yaml :
ai:
    platform:
        typesafe:
            api_key: '%env(TYPESAFE_API_KEY)%'
À quoi ressemble le code
Voici l’appel de la démo, simplifié. $platform est le PlatformInterface de Symfony AI, injecté par autowiring :
use Symfony\AI\Platform\Bridge\TypeSafe\Evaluation;
use Symfony\AI\Platform\Bridge\TypeSafe\Question\ChoiceQuestion;
use Symfony\AI\Platform\Bridge\TypeSafe\Question\NoulQuestion;
use Symfony\AI\Platform\Bridge\TypeSafe\Question\ScoreQuestion;

$result = $platform->invoke('jev-latest', new Evaluation($texteDeLaDemande, [
    'intention' => new ChoiceQuestion('Qu’attend la personne qui a écrit ce message à un service public', [
        'debloquer' => 'Débloquer un dossier : une démarche est en cours et n’avance plus',
        'information' => 'Obtenir une information : elle ne sait pas quoi faire ou comment le faire',
        // ...
    ]),
    'priority' => new ScoreQuestion('À quel point cette demande est urgente à traiter', [
        'Aucune urgence : un remerciement ou une simple remarque',
        'Peut attendre : une gêne sans conséquence concrète',
        'À traiter vite : une démarche est bloquée depuis des semaines',
        'Urgence : la personne est privée de revenus, de papiers ou de soins',
    ]),
    'bug' => new NoulQuestion('Ce message signale un dysfonctionnement du site ou de l’application'),
]));

$answers = $result->asObject();                          // Answers
$answers->getChoice('intention')->getChoice();           // 'debloquer'
$answers->getChoice('intention')->getConfidence();       // 0.9
$answers->getScore('priority')->getScore();              // 2.89
$answers->getNoul('bug')->getProbability();              // 0.86
$answers->getNoul('bug')->isTrue(0.5);                   // true
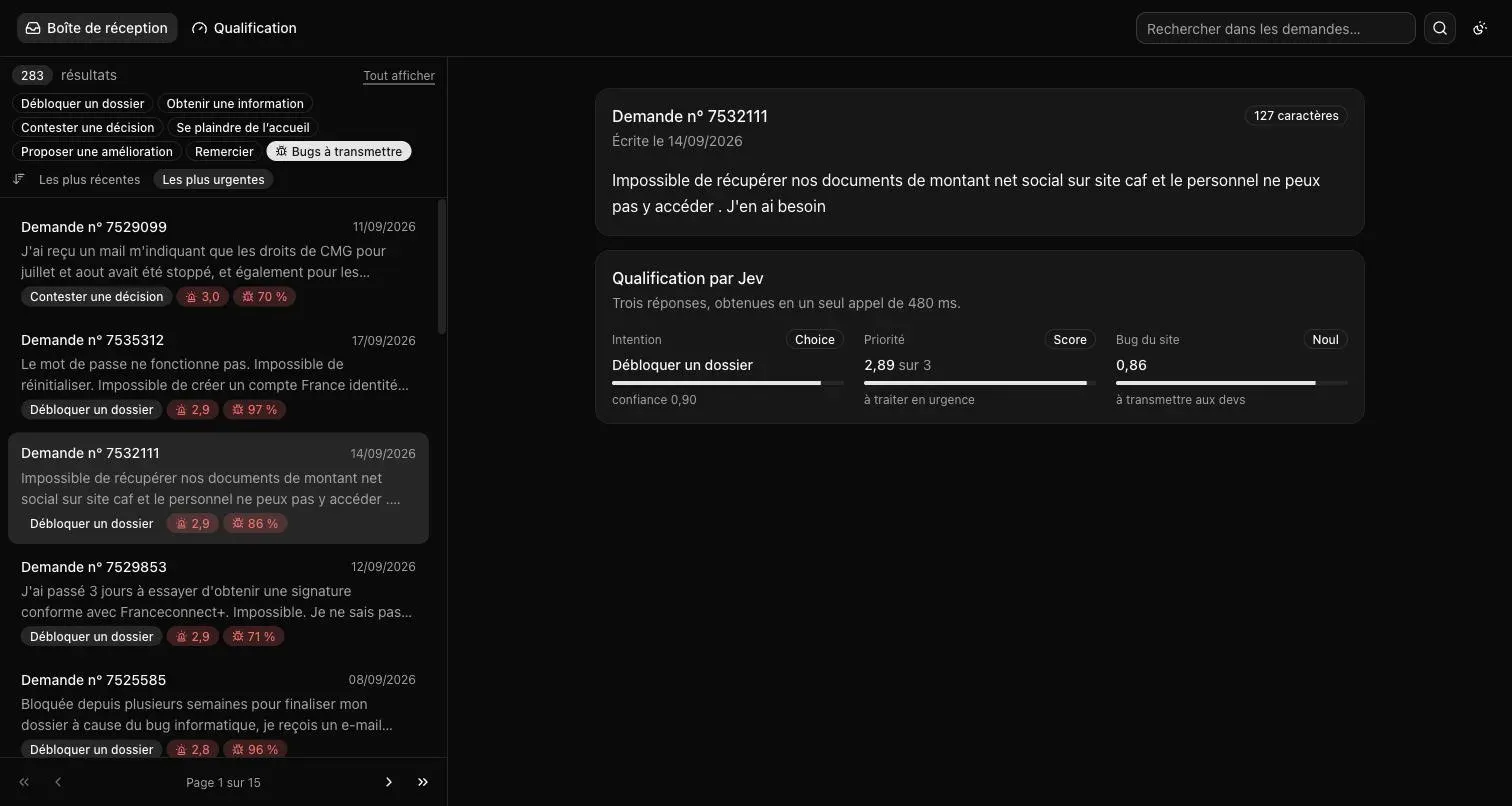
Les valeurs en commentaire ne sont pas inventées : ce sont les réponses de Jev à une vraie demande de la démo, celle qui est ouverte sur la capture de la boîte de réception (« Impossible de récupérer nos documents de montant net social sur site caf… »). Trois réponses, obtenues en un seul appel de 480 ms. C’est la même demande que le JSON de la partie 1, que j’ai obtenu en rejouant l’appel : 0,93, 2,88 et 0,87 cette fois. D’un appel à l’autre, j’ai vu les valeurs bouger de quelques centièmes.
Remarquez trois choses, qui font écho à la partie 2 :
- les clés
intention,priorityetbugne servent qu’à vous, pour retrouver les réponses. Jev ne les voit pas : tout le sens est dans les énoncés (piège n° 1) ; - les niveaux du Score sont décrits en clair. C’est la description qui fait le travail : « privée de revenus, de papiers ou de soins » est autrement plus exploitable que « niveau 3 » ;
- le score vaut 2,89, pas 3 : il tombe entre « à traiter vite » et « urgence », tout près du second. C’est une valeur continue, sur laquelle on peut trier.
Pour le code complet, deux fichiers : src/Command/JevTestCommand.php (un appel de bout en bout) et src/Triage/ExperienceTriage.php (les trois questions de la démo).
5. Ce qu’il faut retenir
Jev est jeune : accès anticipé, une seule version de modèle, et des performances annoncées que personne n’a encore reproduites de façon indépendante. Gardez la tête froide devant les « 444 fois moins cher ».
Mais ce que j’ai pu vérifier moi-même tient debout : le prix est public, le schéma est toujours respecté, la latence médiane est de 441 ms chez moi, et 1 000 demandes en français ont été qualifiées en 25 secondes pour trois centimes. Avec des erreurs, parfois commises avec aplomb, que seuls un seuil bien choisi, une option « autre » et une question bien écrite permettent de contenir.
Le plus intéressant, à mes yeux, n’est pas le modèle : c’est l’architecture qu’il encourage. Pas d’agent qui décide de tout, mais un workflow logiciel ordinaire, avec des if un peu plus malins qu’avant, qui savent dire « je ne suis pas sûr » et passer la main. Du code qui reste du code, testable et lisible, et de l’IA seulement là où il en faut.
Le LLM pour écrire et raisonner. Le System One pour trancher vite. Et votre code pour décider qui fait quoi.
Références
- Le dépôt de démonstration de cet article
- La PR du bridge TypeSafe pour Symfony AI (en cours de revue)
- Billet de lancement : « Introducing System One Models & Jev »
- Documentation TypeSafe : le concept System One, les primitives, modèles et prix, limites connues de Jev 1.13, principes de conception, questions parallèles, AI primer
- jevable.com, la galerie communautaire
- Regards tiers : TrueFoundry (le plus critique), The Rundown
- Le jeu de données de la DITP sur data.gouv.fr
- Symfony AI
Cet article a été écrit avec l’assistance d’une IA. Un System Two, donc : lent et bavard.
Loading comments...